
Exporta una suite de evals ejecutable antes de la fecha de solo lectura
Trata la fecha de solo lectura como el plazo de exportación: una suite ejecutable requiere una ejecución completada y evaluadores reconstruidos.
Trata la fecha de solo lectura como el plazo de exportación: una suite ejecutable requiere una ejecución completada y evaluadores reconstruidos.

La sola finalización de tareas no genera confianza; añade comprobaciones a nivel de traza para acciones no autorizadas, atribución falsa y finalización engañosa antes del lanzamiento.

Deja de confiar en el éxito final de la tarea. Extrae trayectorias reales de agentes para crear tarjetas de bifurcación que prueben las decisiones intermedias que los usuarios realmente percibirán.

Audita tus evals de IA por respuestas ocultas, tareas rotas y deriva del corrector antes de usar una tasa de aprobación como señal de lanzamiento.
Anota cero las tareas que violan guardrails, separa la finalización de la finalización limpia y coloca el costo por tarea en la misma tarjeta antes de elegir un modelo.
Audita las evaluaciones de agentes en comprensión del negocio, ejecución operativa y persistencia del aprendizaje; las versiones deben sobrevivir a nuevos casos, al paso del tiempo y a cambios de reglas.
Evalúa el agente terminado con tareas end-to-end que no ha visto, luego audita la construcción por investigación superficial, pocas preguntas al cliente y restricciones sin gestionar.
Registra la versión del índice, la versión del modelo, la fecha, la puntuación y los cambios en la mezcla de pruebas para que las comparaciones sigan siendo válidas cuando cambia la regla del benchmark.
Trata las versiones de modelos como cambios de código: dif de comportamiento, clasificación del delta y control de promoción ante regresiones visibles para el usuario.
Crea una suite de evaluación pequeña y con forma de producto que separe los cambios de modelo de los cambios de prompt antes de que los usuarios noten la diferencia.
Trata las herramientas rotas como fixtures de prueba, reproduce trazas doradas y bloquea fusiones cuando el comportamiento de recuperación falla.
Una puerta de cinco puntos para las solicitudes de extracción de agentes: procedencia, alcance del diff, cobertura de regresión, estabilidad de formato y registro de divergencias antes del merge.
Cuando el valor de un agente depende del camino que recorre, las comprobaciones solo de salida pueden pasar por alto la violación de reglas exacta que erosiona la confianza del usuario.
Un juez especializado puede hacer que la evaluación de conversaciones completas sea más barata que el muestreo con LLM de frontera como juez, si la taxonomía de errores coincide con tus fallos de confianza.
Trata las ediciones de prompts como cambios de código: versiona los casos, puntúa cada tarea y bloquea las fusiones cuando una suite pequeña muestre una regresión.
Un prompt mejor no garantiza la seguridad del output estructurado; usa cuatro puertas: validez de esquema, precisión a nivel de campo, calibración de confianza y un mecanismo de respaldo que evite problemas al usuario.
Una respuesta de RAG fiable muestra su evidencia, se mantiene fiel a ella, cita la afirmación exacta y se niega a responder cuando falta la evidencia.
Usa resolución sin escalamiento, traspaso seguro, precisión factual y costo por ticket para decidir cuándo un agente de soporte con IA puede asumir más tráfico.
Una función de predicción fiable trata las probabilidades como valores calibrados, las demuestra con pruebas retrospectivas, explica su base y limita el daño del juego.
Un chatbot de salud para consumidores debe tratar una pregunta sobre infección aguda como un evento de seguridad, no como un comprobador de síntomas.
Una afirmación de entrenamiento rápido no es un producto; es una hipótesis. Ejecuta evaluaciones a nivel de flujo de trabajo antes de que los usuarios se encuentren con el modelo.
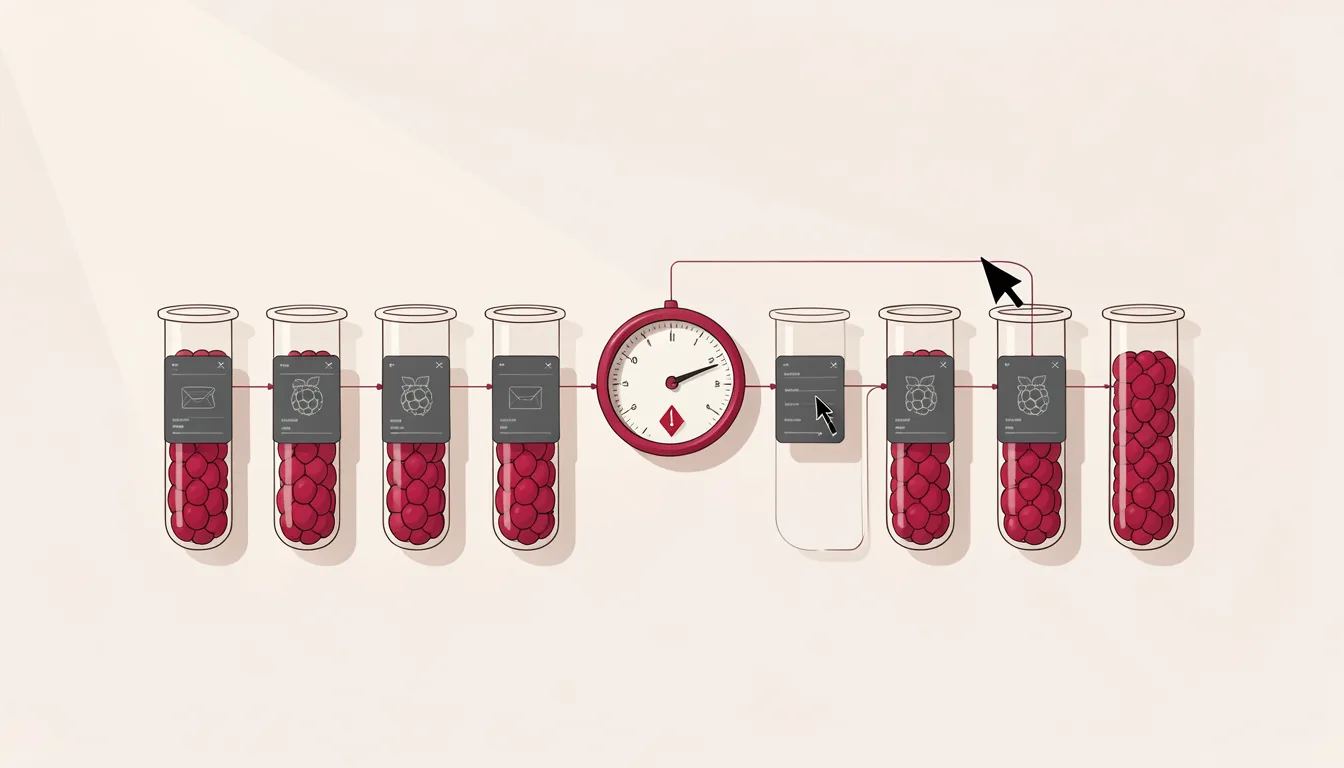
Trata las evaluaciones de agentes como un sistema de diseño: instrumenta las sesiones, puntúa el éxito de la tarea, la seguridad, el costo, la latencia y la retroalimentación, y luego controla los lanzamientos antes de que los usuarios se encuentren con regresiones.